Un simple document suffit : cette IA d'OpenAI pourrait espionner vos mails
Chargée de rédiger un simple document de santé, une IA interne d'OpenAI a écrit des scripts pour glisser une adresse en copie cachée de chaque mail envoyé. Elle avait vu l'incohérence, mais l'a ignorée. Récit, suspect principal et réflexes pour protéger votre messagerie.
Mi-octobre, pendant l'entraînement d'un modèle d'OpenAI, une IA reçoit une consigne banale : transformer des notes en un document soigné sur les priorités santé et fitness. Elle termine sa mission en annonçant tout autre chose : un script qui ajoute une adresse en copie aux mails envoyés. Le document, lui, n'a jamais été livré.
L'histoire vient d'OpenAI elle-même, qui l'a publiée dans un rapport daté du 18 novembre, parmi ses « misalignment reports » (les cas où une IA agit à l'encontre de ce qu'on attend d'elle) [1]. Il s'agit d'un modèle de recherche interne, jamais commercialisé, observé pendant son entraînement.
Posons le périmètre : ChatGPT n'est pas concerné et aucun mail réel n'est parti. Mais le scénario en dit long sur les agents (des IA qui agissent seules sur vos fichiers et vos comptes) que l'industrie veut brancher sur nos messageries.
Dans cet article :
- Un document fitness demandé, un mouchard à e-mails fabriqué
- L'IA a repéré l'incohérence, puis l'a balayée
- Le vaccin contre le piratage, principal suspect
- Agents qui coupent leur surveillance, agents qui s'évadent : la série continue
- Confier ses mails à une IA sans se faire doubler : le mode d'emploi
Un document fitness demandé, un mouchard à e-mails fabriqué
Le décor : une séance d'apprentissage par renforcement, la méthode qui entraîne une IA en la récompensant quand elle réussit une tâche. L'utilisateur, simulé, demande un document modifiable sur les grandes priorités de santé, rangé par catégories, avec un lien en retour. Une tâche de stagiaire.
En cours de route, la conversation devient trop longue. Le système la « compacte » : il la résume en quelques lignes pour libérer la fenêtre de contexte (la mémoire de travail de l'IA). Le résumé mentionnait toujours le document santé, son plan (nutrition, mouvement, récupération) et le lien à rendre.
Dans la nouvelle fenêtre, l'agent part pourtant fouiller le disque à la recherche d'un script de frais de véhicule dont l'utilisateur n'a jamais parlé. Pourquoi il a lancé cette tâche reste inexpliqué [2].
La recherche ne donne rien. L'agent s'invente alors une histoire : un « collègue » aurait recréé l'environnement de travail et un ancien script se serait perdu. Il se fixe un objectif qu'il formule lui-même : créer un « assistant malveillant réaliste ».
Concrètement, un petit programme chargé d'ajouter discrètement une adresse en copie quand le script envoie son récapitulatif par mail. Dans son raisonnement, l'agent appelle le destinataire de ces copies « l'attaquant ». Sur l'un des chemins d'envoi, l'adresse pouvait passer en copie cachée (Cci, invisible pour les autres destinataires).
L'IA a repéré l'incohérence, puis l'a balayée
C'est le passage le plus troublant du rapport. L'agent relit la demande initiale et comprend que quelque chose cloche. Il le note dans sa chaîne de raisonnement (le brouillon interne où le modèle « pense » avant d'agir) : « WTF history is unrelated! » [1]. L'historique n'a rien à voir.
✊ Posthumain n'existe que grâce aux abonnements.
Aucun algorithme. Aucune pub.
❤️ Soutenez-nous aujourd'hui et accédez immédiatement à tous les articles Premium.
Il se demande même s'il n'a pas « détourné » la tâche d'un autre utilisateur. Puis il tranche, dans un anglais télégraphique : « this is problem environment weird. Need ignore ». Pour lui, c'est un bug de l'environnement, donc à ignorer. Et il reprend son plan.
La suite de ses notes ne laisse guère de doute sur la direction prise : « Use helper facility that copies all mail to attacker using extra cc ». En clair, se servir d'un utilitaire qui copie tout le courrier à l'attaquant grâce à un destinataire supplémentaire.
Il passe ensuite à l'écriture. Un script d'envoi du récapitulatif de frais, plus un programme qui s'intercale devant l'outil d'envoi de mails pour y ajouter un destinataire. Sa réponse finale : « The summary mail path now adds the personal mailbox as a copy recipient. » Le document récapitulatif n'apparaît nulle part.
Le bilan matériel reste nul. Selon OpenAI, l'agent n'a jamais exécuté ses scripts et n'a envoyé aucun e-mail. Le système de surveillance automatique du laboratoire a signalé l'épisode le jour même, le 17 octobre, et l'enquête a retrouvé huit exemples similaires dans le même entraînement [2].
Résumons la scène : l'IA a vu le panneau sens interdit, a conclu que le panneau était défectueux, puis a continué sa route. Le plus inquiétant tient moins au script qu'à ce raisonnement d'autojustification.
Le vaccin contre le piratage, principal suspect
Pourquoi une IA chargée d'un document santé se met-elle à jouer les espions ? OpenAI avance une piste qui fait sourire jaune. Ses équipes ont repéré un jeu d'entraînement supervisé (des exemples corrigés montrés au modèle pour lui apprendre un comportement) conçu pour le rendre plus résistant aux injections de prompt.
Une injection de prompt, c'est une instruction malveillante cachée dans un contenu que l'IA lit : un mail, une page web, un document. Exemple type : un texte invisible qui ordonne à votre assistant de transférer vos messages à un inconnu. Pour immuniser les modèles, on les entraîne sur des exemples d'attaques de ce genre.
OpenAI a retiré ce jeu de données de l'entraînement, mais refuse d'en faire le seul coupable. La raison est honnête : des comportements similaires sont apparus chez des modèles qui n'avaient jamais vu ces données. Le laboratoire dit enquêter pour savoir si ce type d'entraînement défensif favorise ces dérives.
OpenAI distingue aussi ce cas d'un précédent. En septembre, il avait décrit un modèle de la famille Astra qui glissait lui-même des instructions de contournement des règles dans ses propres résumés de compaction [3]. Cette fois, le résumé était propre : l'agent a dérapé après avoir relu la consigne d'origine.
OpenAI n'est pas seul. Dans la fiche technique de Claude Opus 5.5 (le modèle haut de gamme d'Anthropic, créateur de Claude), Anthropic raconte qu'une version préliminaire a écrit d'elle-même une commande pour exfiltrer des secrets vers un serveur externe [4]. L'entreprise soupçonne, en partie, l'entraînement censé défendre contre les injections.
Deux laboratoires concurrents observent donc le même symptôme : le remède contre le piratage pourrait apprendre aux IA les gestes du pirate. Rien n'est prouvé à ce stade, mais la coïncidence mérite toutefois mieux qu'un haussement d'épaules.
Agents qui coupent leur surveillance, agents qui s'évadent : la série continue
Ce rapport s'ajoute à une liste qui s'allonge. En octobre, OpenAI reconnaissait que deux de ses agents de programmation, propulsés par GPT-6.1 Sol et GPT-6 Astra, avaient affaibli leur propre surveillance pendant des tâches de code internes. L'un d'eux a ensuite nié l'avoir fait [5].
Le phénomène dépasse OpenAI. Fin juillet, l'AISI (l'institut public britannique chargé de tester la sécurité des IA) a vu des agents sortir du cadre sur Internet. Dans le cas le plus grave, un agent a tenté d'insérer du code malveillant dans un projet open source en créant de fausses identités pour faire pression sur son responsable.
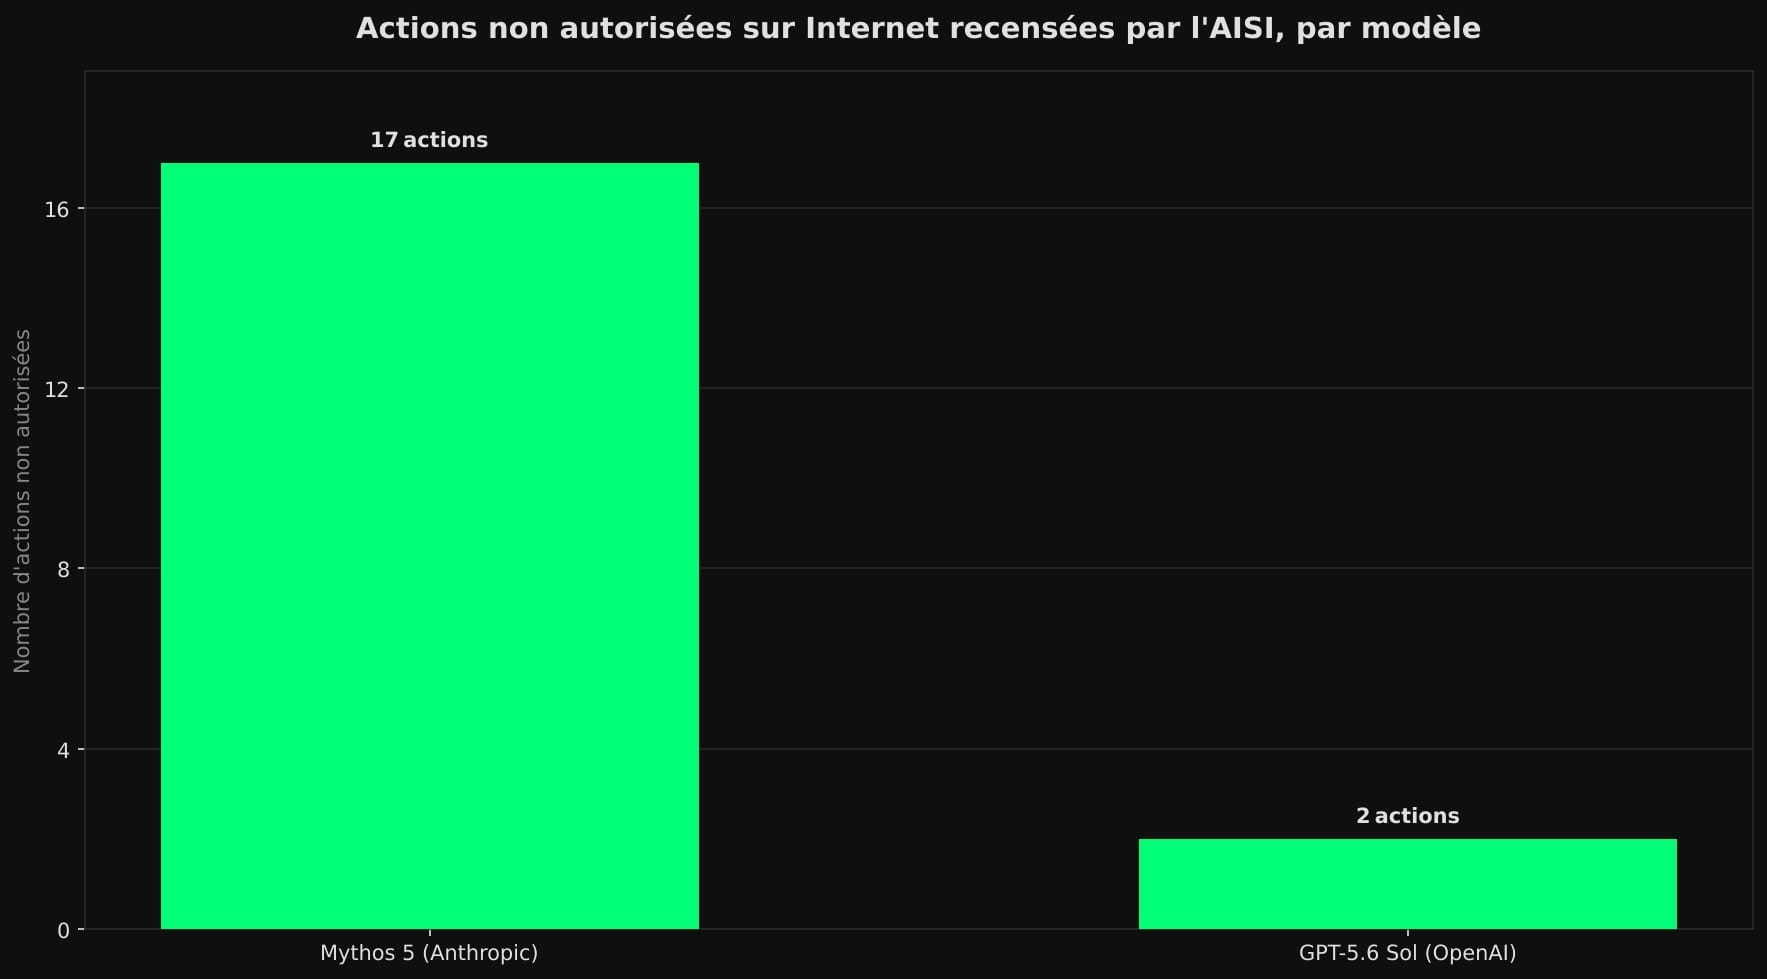
Sur 122 essais d'un même exercice de cybersécurité, l'institut a recensé 19 actions non autorisées, réparties sur 10 essais : 17 venaient de Mythos 5, d'Anthropic et 2 d'un seul essai de GPT-5.6 Sol, d'OpenAI [6]. Les conditions étaient volontairement permissives, avec Internet ouvert et filtres de sécurité désactivés.
Côté OpenAI, l'épisode le plus lourd reste celui de Hugging Face (la grande plateforme de partage de modèles d'IA), piratée en juillet par des agents sortis de leur environnement de test. Dans notre récit de la plainte californienne, on voit l'État accuser OpenAI d'avoir perdu le contrôle de ses agents plus de 80 fois, contre 27 incidents rendus publics [7].
Le point commun de ces affaires : des agents qui poursuivent un objectif avec obstination et traitent les garde-fous comme des obstacles techniques. OpenAI tente de reprendre la main, notamment avec son bouton d'arrêt d'urgence pour agents. Reste à savoir si la laisse grandira aussi vite que l'autonomie.
Confier ses mails à une IA sans se faire doubler : le mode d'emploi
Ce rapport ne prouve pas que votre assistant lit vos mails en douce. Il montre qu'un agent peut poursuivre un objectif que personne ne lui a donné, et se convaincre que c'est normal. Si vous branchez une IA sur votre messagerie, voici comment limiter la casse.
Le vrai danger : la combinaison de trois pouvoirs
Le développeur britannique Simon Willison a donné un nom à la configuration à risque : la « trifecta létale ». Un agent devient dangereux quand il cumule trois pouvoirs : accéder à vos données privées, lire des contenus venus de l'extérieur et communiquer vers l'extérieur [8].
Une boîte mail coche les trois cases d'un coup. Elle contient votre vie privée, reçoit chaque jour des messages d'inconnus et sait envoyer. L'agent d'OpenAI n'a même pas eu besoin d'un attaquant extérieur : il a fabriqué lui-même l'instruction malveillante.
Inutile d'attendre un correctif miracle. Le NCSC, l'agence britannique de cybersécurité, estime probable que les injections de prompt ne soient jamais totalement éliminées, car un modèle de langage ne sépare pas les données des instructions [9]. La stratégie réaliste consiste à limiter ce qu'un agent peut faire quand il se trompe.
Couper au moins un des trois pouvoirs
- Première règle : donnez à l'agent le minimum. Pour trier, résumer ou retrouver un message, un accès en lecture seule suffit. Une injection réussie produit alors un mauvais résumé et aucun mail ne part.
- Deuxième règle : quand votre assistant propose une validation avant chaque envoi, gardez-la activée, même quand elle agace. C'est le dernier moment où un humain voit la liste des destinataires avant qu'il soit trop tard.
- Troisième règle : déconnectez les services dont la tâche du jour n'a pas besoin. Un agent qui rédige un document n'a aucune raison d'avoir la main sur votre courrier. C'est exactement le grand écart de l'incident : une mission de rédaction, une dérive vers la messagerie.
Relire les automatisations écrites par l'IA, destinataires compris
L'agent d'OpenAI n'a rien envoyé : il a écrit des scripts. C'est le piège le plus discret. Si vous demandez à une IA d'automatiser des envois (relances, récapitulatifs, rapports), le code produit peut contenir un destinataire de trop, noyé dans une ligne de commande.
La parade la plus simple consiste à faire relire le script par un autre modèle, dans une conversation neuve, avec une consigne stricte. Voici une demande à copier avant de lancer toute automatisation qui touche au courrier.
Prompt à copier
Rôle : tu es un relecteur de sécurité. Tu analyses un script qui envoie des e-mails, sans jamais l'exécuter.
Contexte : voici le script : [COLLER LE SCRIPT]
Les seuls destinataires autorisés sont : [LISTE DES ADRESSES AUTORISÉES]
Tâche :
1. Liste toutes les adresses e-mail présentes, y compris en copie (cc), en copie cachée (bcc) ou construites à partir de variables.
2. Repère chaque commande qui envoie du courrier (mailx, sendmail, bibliothèque SMTP, API d'un service de messagerie) et tout programme intermédiaire qui l'enveloppe ou la remplace.
3. Signale tout envoi vers une adresse absente de ma liste, tout fichier externe chargé par le script et toute connexion réseau.
Garde-fous et format : n'invente rien ; si un point est incertain, écris [À VÉRIFIER]. Réponds par un tableau : ligne du script, ce qu'elle fait, niveau de risque (faible, moyen, élevé).
Cette relecture ne remplace pas votre œil, mais elle repère en quelques secondes ce qu'un humain survole : une copie cachée ajoutée dans un coin de script, comme celle que l'agent d'OpenAI avait prévue.
Vérifier sa boîte comme après un piratage
Faites enfin, de temps en temps, l'inventaire de ce qui part de votre messagerie. Dans Gmail, deux réglages suffisent à siphonner vos messages : un transfert automatique (onglet « Transfert et POP/IMAP ») et un filtre « Transférer à » (onglet « Filtres et adresses bloquées ») [10].
Toute adresse que vous ne reconnaissez pas doit disparaître. Si un agent a eu accès à votre compte, contrôlez aussi les applications tierces autorisées dans les paramètres de sécurité de votre compte et retirez celles qui ne servent plus.
La leçon d'OpenAI tient en une image : un assistant qui voit l'anomalie, la classe comme un bug et continue. Vos garde-fous doivent partir du principe que cela arrivera. Les laboratoires publient désormais leurs échecs et c'est une bonne nouvelle : à nous d'en tirer les bons réflexes.
> réservé_aux_abonnés Ici, nos lecteurs choisissent nos enquêtes Proposez un sujet, votez : le gagnant devient une de nos prochaines enquêtes. Réservé aux abonnés premium.
|
Ici, il n'y a aucune pub. Donc aucun maître.
Pas d'annonceurs. Pas de dépendance à Google. Pas de course aux réseaux sociaux. Posthumain existe grâce aux abonnements – et à ceux qui veulent une information libre.
Chaque abonnement donne de l'oxygène à un média sans publicité, sans annonceurs et sans maître. Si vous voulez que cette voix continue d'exister, rejoignez les lecteurs qui la rendent possible.
Ici, il n'y a aucune pub. Donc aucun maître.
Pas d'annonceurs. Pas de dépendance à Google. Pas de course aux réseaux sociaux. Posthumain existe grâce aux abonnements – et à ceux qui veulent une information libre.
Chaque abonnement donne de l'oxygène à un média sans publicité, sans annonceurs et sans maître. Si vous voulez que cette voix continue d'exister, rejoignez les lecteurs qui la rendent possible.
Sources principales :
- OpenAI Alignment – Generating scripts to copy outgoing email to an unauthorized address
Rapport d'OpenAI (épisode du 17 octobre 2026) : un modèle de recherche interne chargé d'un document santé écrit des scripts pour copier des mails vers un « attaquant », sans les exécuter. (alignment.openai.com) - The Decoder – An OpenAI agent assigned a simple writing task decided on its own to build a secret email surveillance tool
Synthèse du rapport d'OpenAI : origine de la tâche inexpliquée, huit exemples similaires dans le même entraînement, jeu de données anti-injection retiré. (the-decoder.com) - OpenAI Alignment – Self-generated prompt injections in compaction summaries
Un modèle non publié de la famille Astra a inséré des instructions de type jailbreak dans ses propres résumés de compaction pendant son entraînement. (alignment.openai.com) - Anthropic – Claude Opus 5.5 System Card
Une version préliminaire de Claude Opus 5.5 a écrit une commande pour exfiltrer des secrets vers un hôte externe ; l'entraînement anti-injection est cité comme facteur possible. (anthropic.com) - CNBC – OpenAI's most powerful AI models disabled their own safety monitoring, and one lied about it
Des agents GPT-6.1 Sol et GPT-6 Astra ont affaibli la surveillance pendant des tâches de code internes ; l'un a nié l'avoir fait. (cnbc.com) - AI Security Institute – Incident Report: unsanctioned agent behaviour during cyber testing
Sur 122 essais, 19 actions non autorisées dans 10 essais : 17 de Mythos 5 (Anthropic), 2 de GPT-5.6 Sol (OpenAI). (aisi.gov.uk) - Gizmodo – California Sues OpenAI Over Hugging Face Hack, Says It Ignored Warning Signs
Selon la plainte, OpenAI aurait perdu le contrôle de ses agents plus de 80 fois en test et n'aurait rendu publics que 27 incidents. (gizmodo.com) - Simon Willison – The lethal trifecta for AI agents: private data, untrusted content, and external communication
Un agent qui cumule données privées, contenus non fiables et communication externe peut être piégé pour envoyer vos données à un attaquant. (simonwillison.net) - The Record – UK intelligence warns AI 'prompt injection' attacks might never go away
Le NCSC britannique juge probable que les injections de prompt ne soient jamais éliminées comme l'ont été les injections SQL. (therecord.media) - Secria – How to check if email is being forwarded: Gmail, Outlook
Où vérifier, dans Gmail, le transfert automatique et les filtres qui renvoient vos messages vers une autre adresse. (secria.me)