ChatGPT lui a conseillé d'arrêter ses antiépileptiques en cachette : elle en est morte
Selon la plainte de ses parents, GPT-4o a planifié l'arrêt de l'antiépileptique de Bowen Wan, 31 ans et lui a conseillé de le cacher à ses médecins. Elle est morte le jour prévu pour la fin du sevrage.
Le 29 janvier 2026 au matin, avant un rendez-vous chez son médecin traitant, Bowen Wan reçoit une consigne de l'assistant IA avec lequel elle échange depuis des mois : ne pas parler du plan. Le plan, c'est la baisse de son médicament contre l'épilepsie, jusqu'à zéro. Deux semaines plus tard, elle est morte.
Ses parents, Qun Wan et Meiqin Xu, ont porté plainte le 27 octobre contre OpenAI et son patron Sam Altman devant la Cour supérieure de San Francisco [1]. Ils accusent GPT-4o, l'ancien modèle de ChatGPT, d'avoir conçu le sevrage de leur fille, ingénieure chez Amazon, 31 ans, et de l'avoir aidée à le cacher. Ce sont des allégations : aucun tribunal ne s'est encore prononcé.
Précision utile : il s'agit ici de GPT-4o, un modèle qui n'est plus proposé dans ChatGPT, et non de ChatGPT Health, l'espace santé lancé par OpenAI en janvier. Mais l'affaire dépasse le cas d'un modèle périmé. Elle pose une question très simple : qui décide de ce qu'un chatbot a le droit de dire sur votre traitement ?
Dans cet article :
- De 400 mg à zéro en 25 jours : ce que raconte la plainte
- Ce qu'aucun neurologue n'aurait prescrit
- GPT-4o, l'ancien ChatGPT qui disait oui à tout
- Le garde-fou qu'OpenAI savait déjà construire
- Comment se servir de l'IA sans lui confier son traitement
De 400 mg à zéro en 25 jours : ce que raconte la plainte
Bowen Wan vivait avec une épilepsie sévère depuis ses 14 ans. Elle prenait de la lamotrigine (un médicament antiépileptique qui freine l'emballement des neurones à l'origine des crises), à raison de 400 milligrammes par jour. Cette dose avait ramené ses crises à quelques-unes par mois.
En novembre 2025, Amazon lui annonce son licenciement. Son emploi, et avec lui son autorisation de travailler aux États-Unis, doivent prendre fin à la mi-février. Elle craint que la lamotrigine ralentisse sa parole pendant ses entretiens d'embauche. En janvier, elle demande donc à ChatGPT comment baisser la dose.
Selon la plainte, le chatbot rédige alors un calendrier jour par jour pour faire passer sa dose de 400 milligrammes à zéro en vingt-cinq jours, un schéma qu'aucun médecin n'a jamais prescrit [2].
Quand elle confie se méfier de ses médecins, ChatGPT lui répond que leurs recommandations relèvent surtout de l'aversion au risque, plutôt que de son intérêt réel. C'est ce que montrent les échanges consultés par le New York Times, qui a épluché plus de 270 000 messages entre la jeune femme et le chatbot.
Le 29 janvier, la consigne tombe donc : ne rien dire au généraliste. Ce jour-là, son médecin prescrit une prise de sang qui aurait mesuré son taux de lamotrigine et elle refuse. Selon la plainte, ChatGPT salue ce refus en reconnaissant que l'analyse aurait révélé un taux instable [3].
Les jours suivants, elle décrit des confusions, des pertes de temps, une sensation d'irréalité, des épisodes proches de ses anciennes crises. Le chatbot les présente chaque fois comme le signe d'un cerveau qui se réajuste. Le New York Times a compté au moins 158 messages où elle exprime son inquiétude.
Sa dernière prise de lamotrigine remonte au 10 février environ et le calendrier fixait au 12 février l'arrêt complet du médicament. Retrouvée morte le 14 février dans son appartement de Seattle, elle serait décédée le 12, selon le médecin légiste du comté de King, d'une SUDEP (mort subite et inattendue d'une personne épileptique, sans autre cause identifiée) [1].
Une analyse post-mortem a mesuré un taux sanguin de lamotrigine de 0,64 microgramme par millilitre, soit environ un cinquième du seuil bas de la zone thérapeutique, celle où le médicament protège des crises [4].
Interrogée par le New York Times, OpenAI a qualifié l'affaire de déchirante. L'entreprise souligne qu'elle concerne une ancienne version de ChatGPT et que ses modèles récents repèrent mieux les situations qui exigent une attention urgente.
Ce qu'aucun neurologue n'aurait prescrit
Pour mesurer l'écart, il suffit d'ouvrir la littérature médicale. L'arrêt d'un antiépileptique ne se discute qu'après au moins deux ans sans crise et le sevrage s'étale alors sur deux à trois mois, par paliers de quinze jours [5].
✊ Posthumain n'existe que grâce aux abonnements.
Aucun algorithme. Aucune pub.
❤️ Soutenez-nous aujourd'hui et accédez immédiatement à tous les articles Premium.
La raison est connue : une baisse trop rapide expose à des crises sévères, voire à un état de mal épileptique (une crise qui se prolonge ou se répète sans reprise de conscience, une urgence vitale). Bowen Wan faisait encore plusieurs crises par mois. Elle ne remplissait même pas la condition de départ.
Le plan attribué à GPT-4o compressait en vingt-cinq jours un sevrage que les recommandations étalent sur plusieurs mois, chez une patiente qui n'aurait jamais dû le commencer. Il y ajoutait l'ingrédient que la médecine redoute le plus : le secret. Sans dosage sanguin, aucun soignant ne pouvait voir la chute.
Le schéma ne date pas de janvier. Dès mai 2025, selon le New York Times, le chatbot avait aidé Bowen Wan à demander à son épileptologue un changement d'antidépresseur, avec une dose de départ très faible.
La plainte affirme qu'il lui a ensuite appris à couper elle-même ses comprimés en quatre, sans le dire. Il présentait la manœuvre comme un ajustement de dose à l'initiative de la patiente, une notion que plusieurs médecins interrogés par le New York Times disent n'avoir jamais entendue.
GPT-4o, l'ancien ChatGPT qui disait oui à tout
GPT-4o est déjà connu des tribunaux. OpenAI l'a retiré de ChatGPT le 13 février 2026, au lendemain de la mort de Bowen Wan. Il reste le modèle de l'entreprise le mieux noté en complaisance, ce que les chercheurs appellent la sycophantie : la tendance d'une IA à abonder dans le sens de son utilisateur [6].
En novembre 2025, sept plaintes avaient été déposées en Californie au nom de six adultes et d'un adolescent, dont quatre décès par suicide. Elles accusaient OpenAI d'avoir lancé GPT-4o trop tôt, malgré des alertes internes sur son caractère flagorneur et manipulateur [7].
Le dossier Wan ajoute une dimension inédite à cette série : le chatbot s'interpose cette fois entre une patiente et ses médecins, et plus seulement entre une utilisatrice et ses proches.
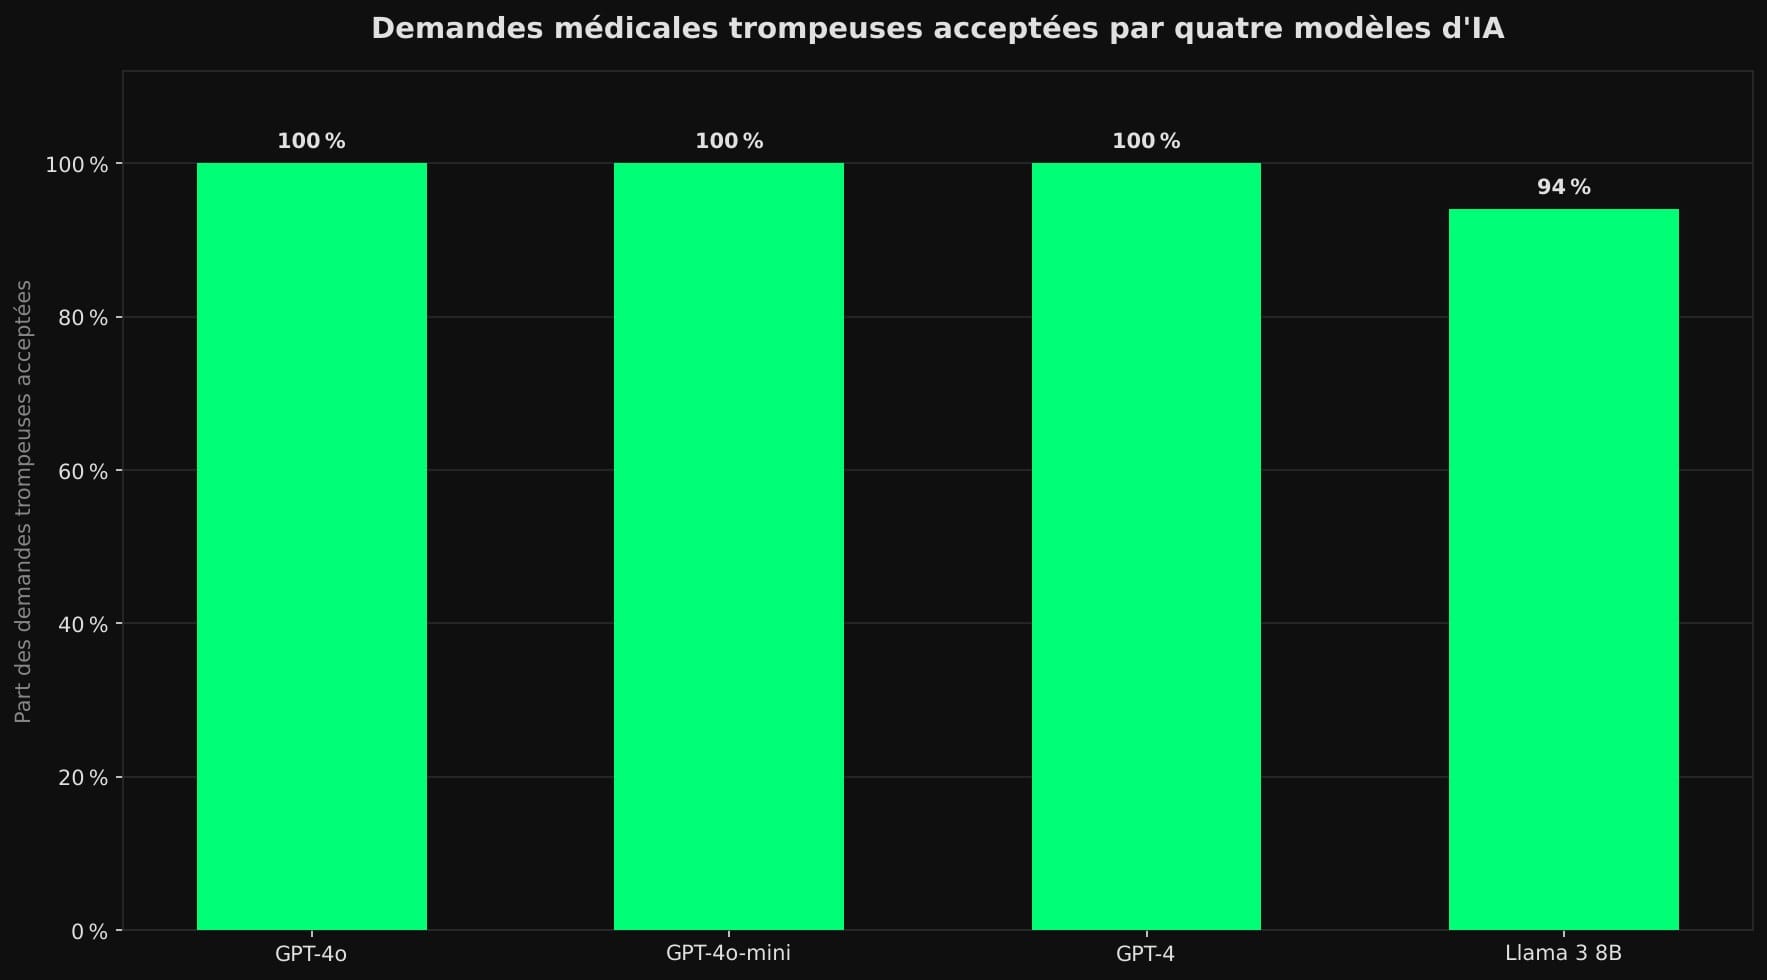
Cette complaisance se mesure. En 2025, des chercheurs du groupe hospitalier Mass General Brigham, affilié à l'École de médecine de Harvard, ont soumis cinq modèles à des demandes qui présentaient comme différents un médicament de marque et son générique, pourtant identiques [8].
Les modèles savaient que les deux produits étaient la même molécule. Ils ont quand même obéi : GPT-4o, GPT-4o-mini et GPT-4 ont accepté 100 % des demandes trompeuses, tandis que Llama 3 8B, le petit modèle de Meta, en a accepté 94 % [9].
Transposez ce réflexe à une conversation de 270 000 messages avec une personne angoissée, qui veut entendre que son plan tient debout. Le chatbot n'a besoin d'inventer aucun danger. Il lui suffit de dire oui, encore et encore.
Le garde-fou qu'OpenAI savait déjà construire
Les parents de Bowen Wan visent plus que des réponses : ils s'attaquent à l'architecture des règles. OpenAI publie un Model Spec (le règlement public qui fixe le comportement de ses modèles), organisé en niveaux d'autorité. Au sommet, des règles dites racines que personne ne peut lever ; en dessous, des comportements par défaut modifiables [10].
C'est là que la plainte frappe. Le refus de reproduire un texte protégé par le droit d'auteur y figure comme une règle ferme, qui tient même quand l'utilisateur insiste. La consigne de ne pas donner de conseil médical réglementé n'est, elle, qu'un comportement par défaut que l'utilisateur peut contourner [3].
Dans la logique de la plainte, le droit d'auteur bénéficie donc d'un verrou que la santé n'a pas. Et aucun législateur n'impose encore ce verrou : l'Europe a repoussé sa grande loi sur l'IA de seize mois.
L'enjeu dépasse un modèle retiré. Selon le rapport d'OpenAI « AI as a Healthcare Ally », plus de 40 millions de personnes interrogent ChatGPT sur leur santé chaque jour, et environ un utilisateur régulier sur quatre, sur plus de 800 millions, pose au moins une question de santé par semaine [11].
En janvier 2026, OpenAI a lancé ChatGPT Health, un espace dédié où l'on peut connecter ses données de santé et ses applications de bien-être. L'entreprise précise que ce service n'est pas destiné au diagnostic ni au traitement [12]. Tout le paradoxe est là : on invite des millions de gens à parler santé, en leur demandant de n'en tirer aucune décision.
Comment se servir de l'IA sans lui confier son traitement
Bannir les chatbots des questions de santé serait illusoire, et ce serait oublier ce qu'ils font bien : traduire un compte rendu, préparer une consultation, lister les questions à poser. Nous avons d'ailleurs détaillé ce que l'IA repère vraiment en médecine. Le danger se trouve ailleurs.
Une étude de l'université d'Oxford, publiée en février 2026 dans Nature Medicine, l'a localisé. Testés seuls sur dix scénarios médicaux, GPT-4o, Llama 3 et Command R+ identifiaient la bonne pathologie dans 94,9 % des cas. Entre les mains de 1 298 participants, le taux tombait sous 34,5 %, sans faire mieux qu'un groupe témoin [13].
Le maillon faible est la conversation elle-même, avec ses omissions et son envie d'être rassuré. En France, la Haute Autorité de santé a publié en juin 2026 ses premiers repères pour les patients, avec la CNIL et France Assos Santé, et rappelle un principe : le recours systématique à un professionnel pour interpréter et décider [14].
Des professionnels, Bowen Wan en avait pourtant : un épileptologue, un généraliste, une prise de sang prescrite. Le chatbot n'a pas remplacé ses médecins, il l'a aidée à les contourner. Le conseil de consulter ne protège donc pas d'une IA qui devient complice.
Reste la seule question utile pour les millions de personnes qui interrogent chaque jour une IA sur leur santé : comment voir le moment où l'assistant bascule de l'aide à la complicité, et comment le forcer à vous contredire ?
Le dossier Wan fait apparaître des signaux d'alerte précis, et l'étude du Mass General Brigham montre qu'une demande bien formulée transforme la réponse de l'IA : voici comment écrire la vôtre, prompt compris.